Faire de la segmentation d’instances en temps réel sur du matériel embarqué ne demande pas seulement un modèle rapide. La capture de la caméra, la préparation des images, l’inférence, la création des masques, le dessin et l’affichage doivent tous tenir dans le temps disponible pour chaque image. Cet article explique comment nous avons optimisé l’ensemble de cette chaîne sur le Renesas RZ/V2H.
Nous avons d’abord mesuré chaque étape, de la caméra USB à l’écran. L’inférence du modèle est une étape importante, mais ce n’était pas le principal goulot d’étranglement dans cette application. Le traitement des images par le processeur et leur affichage prenaient davantage de temps. Nous avons donc optimisé la chaîne complète, en commençant par les plus grandes sources de latence. Le résultat est notable : la cadence, initialement d’environ 11 images par seconde, se situe désormais entre 27 et 29 images par seconde.
Une fois ces principaux goulots d’étranglement éliminés, nous avons évalué l’élagage (pruning) des modèles comme étape suivante de l’optimisation. L’élagage met à zéro les poids les moins utiles afin que le matériel qui le prend en charge puisse éviter une partie des calculs. Nous avons testé l’élagage de modèles de segmentation d’instances issus de trois familles YOLO pour voir son effet sur le temps d’inférence sur DRP-AI3 et sur la taille du modèle compilé.
Tous les essais ont été réalisés sur une carte Renesas RZ/V2H. Quatre cœurs Arm Cortex-A55 exécutent le programme et traitent les images, un accélérateur spécialisé appelé DRP-AI3 exécute le réseau neuronal et un processeur graphique Mali-G31 (GPU) contribue à l’affichage de l’image finale.
Composant
Rôle dans le programme
Processeur Arm Cortex-A55 (CPU)
Gestion de la caméra, préparation des entrées du modèle, masques, dessin et composition de l’image affichée
Accélérateur DRP-AI3
Exécution du modèle de segmentation d’instances
Processeur graphique Mali-G31 (GPU)
Mise à l’échelle et rendu de l’image terminée
Caméra USB
Capture d’images
Configuration d’exécution
Les quatre cœurs du processeur fonctionnaient à 1,2 GHz et DRP-AI3 à 1 GHz. La caméra fournissait des images, et les modèles de segmentation prenaient une entrée de taille fixe de 224 × 224. Tous les essais utilisaient les mêmes réglages de la carte, la même taille d’image de la caméra et le même circuit d’affichage plein écran.
Pour comparer l’ancienne et la nouvelle version du programme, nous avons utilisé le même modèle de segmentation YOLOv8n. Toute variation de la cadence provenait donc du code qui l’entoure. Pour les essais d’élagage, nous avons fait l’inverse : le programme amélioré est resté le même, et seul le modèle déployé a changé.
Dans cet article, l’inférence désigne l’exécution du réseau neuronal sur DRP-AI3. Ce n’est qu’une étape parmi d’autres. Les autres comprennent la capture, la préparation des entrées du modèle, la création des masques, le dessin et l’affichage.
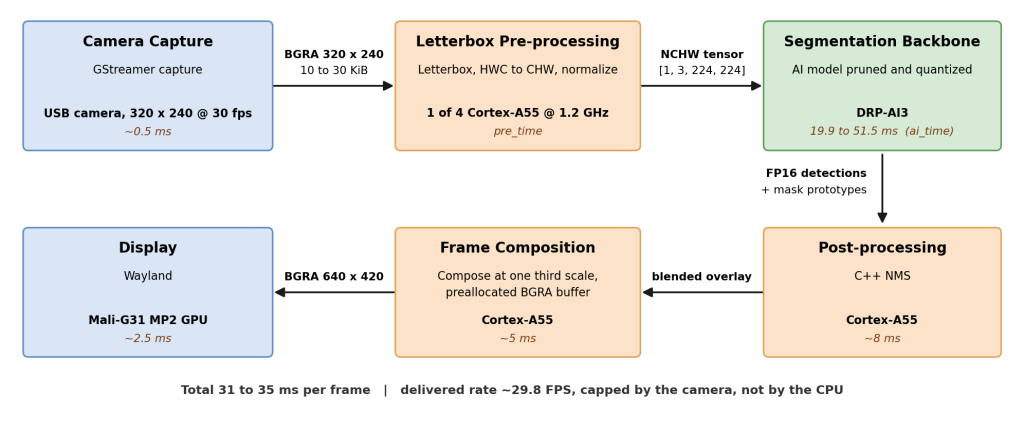
Le parcours de base est resté le même dans les deux versions. L’interface V4L2 de Linux reçoit une image de la caméra, puis GStreamer la convertit au format BGR, qui stocke pour chaque pixel les valeurs du bleu, du vert et du rouge. Le processeur redimensionne ensuite l’image à 224 × 224 et ajoute des marges au besoin pour en conserver les proportions (méthode letterbox).
Le processeur réorganise les pixels dans l’ordre CHW (canaux, hauteur, largeur) attendu par le modèle et normalise leurs valeurs. DRP-AI3 exécute alors le réseau, qui renvoie des boîtes englobantes, des scores de confiance et les données nécessaires à la création des masques.
Après l’inférence, le processeur élimine les boîtes en double pour un même objet, construit les masques, dessine les résultats et compose l’image à afficher. La chaîne d’affichage transmet cette image au processeur graphique, qui la met à l’échelle, puis Weston l’affiche à l’écran.
Le parcours de la caméra à l’écran
Pourquoi nous avons commencé en dehors du modèle
Au départ, le modèle semblait être le candidat évident à optimiser. Puis nous avons mesuré le temps nécessaire pour traiter chaque image. La première version du programme prenait environ 90 à 130 ms (millisecondes) par image, soit environ 8 à 11 images par seconde, tandis que le modèle ne représentait que 25 à 30 ms de ce temps. Le plus gros du délai se trouvait ailleurs.
Nous avons d’abord mesuré le traitement complet d’une image
Nous avons découpé le traitement de chaque image en grandes étapes et mesuré la durée de chacune. Les chiffres ci-dessous proviennent d’un seul essai et doivent donc être considérés comme des ordres de grandeur. Ils suffisaient néanmoins pour déterminer où agir en premier.
Les mesures couvraient la capture, la préparation des entrées du modèle, l’inférence sur DRP-AI3, le traitement des sorties, la composition de l’image et l’affichage. Comme la capture comprend le temps d’attente de l’image suivante, nous avons suivi à la fois le temps de traitement et le temps écoulé entre deux images affichées. C’est ce dernier qui détermine la cadence réellement obtenue.
Étape
Durée approximative avant les changements
Cause de cette durée
Création et dessin des masques d’instances
~25 à 45 ms
Chaque détection relançait de grosses opérations sur l’image et son propre calcul de masque
Composition de l’image affichée
~20 à 30 ms
Le processeur redimensionnait et composait une image à pleine résolution
Conversion du format d’image
~8 à 20 ms
La conversion s’effectuait sur la grande image finale
Transfert de l’image au GPU pour affichage
~10 à 14 ms
Chaque image nécessitait le transfert de près de 10 Mio de données vers le GPU
Capture de la caméra
~2 à 5 ms
La chaîne de capture transférait des images non compressées
Durées approximatives relevées lors d’un essai avant les changements.
Aucune étape n’expliquait à elle seule tout le délai, mais plusieurs répétaient des opérations sur de grandes images. Le programme agrandissait l’image de la caméra trop tôt, puis copiait, convertissait, mélangeait et transférait cette grande image à plusieurs reprises. Certaines opérations étaient aussi répétées pour chaque objet détecté.
Nous avons donc décidé de réduire la taille des images traitées par le processeur, de supprimer les calculs et les dessins répétés des masques, et de diminuer la quantité de données provenant de la caméra. Le modèle, lui, est resté inchangé.
Optimiser les étapes autres que l’inférence
Composer une image plus petite, puis l’agrandir pour l’affichage
Le gain le plus important est venu de la séparation entre la taille de traitement et la taille d’affichage. À l’origine, le processeur composait toute l’image à la taille de l’écran (1920×1080). Désormais, il compose une image de 640 × 420, que le processeur graphique agrandit pour remplir la fenêtre en plein écran.
La fenêtre mesure 1920 × 1260, zone de titre comprise. L’ancienne version agrandissait l’image de la caméra à 1440 × 1080 avant de la placer dans cette fenêtre. La nouvelle ne l’agrandit qu’à 480 × 360 et compose l’image entière à 640 × 420. La taille de la fenêtre, elle, ne change pas.
Chaque opération sur l’image complète porte maintenant sur environ 1,1 Mio plutôt que 9,7 Mio. L’agrandissement final est confié au processeur graphique, conçu précisément pour cette tâche. Dans notre essai, ce seul changement a permis de gagner environ 25 à 30 ms par image.
Produire tous les masques ensemble
Un modèle de segmentation d’instances produit un masque distinct pour chaque objet. Pour chaque détection, il renvoie 32 coefficients de masque, associés à un tenseur de prototypes de masque commun à toutes les détections. L’ancien programme multipliait séparément chaque ensemble de coefficients par ce tenseur. Chaque objet déclenchait donc une nouvelle multiplication matricielle et une nouvelle lecture des mêmes prototypes.
Le nouveau programme rassemble les coefficients de toutes les détections dans une seule matrice. Une seule multiplication matricielle produit ainsi tous les masques d’un coup. Nous limitons aussi l’affichage à huit masques par image pour éviter que les scènes chargées causent de longs délais. Ensemble, ces changements ont permis de gagner environ 10 à 15 ms.
Fusionner les calques une seule fois par image
L’ancienne méthode de dessin créait et fusionnait un calque de superposition couvrant toute l’image pour chaque objet. Huit objets entraînaient donc huit copies et huit fusions. La nouvelle méthode dessine tous les objets sur un même calque et ne le fusionne qu’une fois.
Chaque masque détermine toujours les pixels qui prennent la couleur de l’objet. La différence, c’est que le programme attend que tous les masques soient dessinés sur le calque commun avant de le combiner avec l’image de la caméra. Le résultat visuel est identique et, selon le nombre d’objets, cette modification a permis de gagner environ 8 à 20 ms par image.
Convertir la petite image plutôt que la grande
La chaîne de capture fournit une image BGR à trois canaux, tandis que l’affichage utilise le format BGRA, qui ajoute un canal alpha pour la fusion. Auparavant, le programme effectuait cette conversion sur la grande image affichée. Nous l’avons déplacée vers la petite image de la caméra, de 320 × 240, et avons conservé le format BGRA pour le reste de la composition.
Les éléments fixes, comme la zone de titre, sont maintenant préparés une seule fois puis réutilisés. Les tampons d’affichage sont également réutilisés au lieu d’être recréés à chaque image. On obtient la même image avec moins de travail.
Utiliser un flux compressé pour la caméra
À l’origine, la caméra transmettait des images YUYV brutes. Désormais, le programme lui demande du MJPEG, un format compressé qu’elle prend en charge. À 320 × 240, une image MJPEG pesait environ 10 à 30 Kio, contre quelque 150 Kio pour une image YUYV brute.
GStreamer décode l’image JPEG et la convertit au format BGR utilisé par le programme. Dans notre essai, le décodage ajoutait moins d’une milliseconde, alors que beaucoup moins de données circulaient sur USB. Le gain global était modeste. L’essentiel de l’amélioration provenait toujours de la réduction de la taille des images affichées.
Résultats des modifications apportées au programme
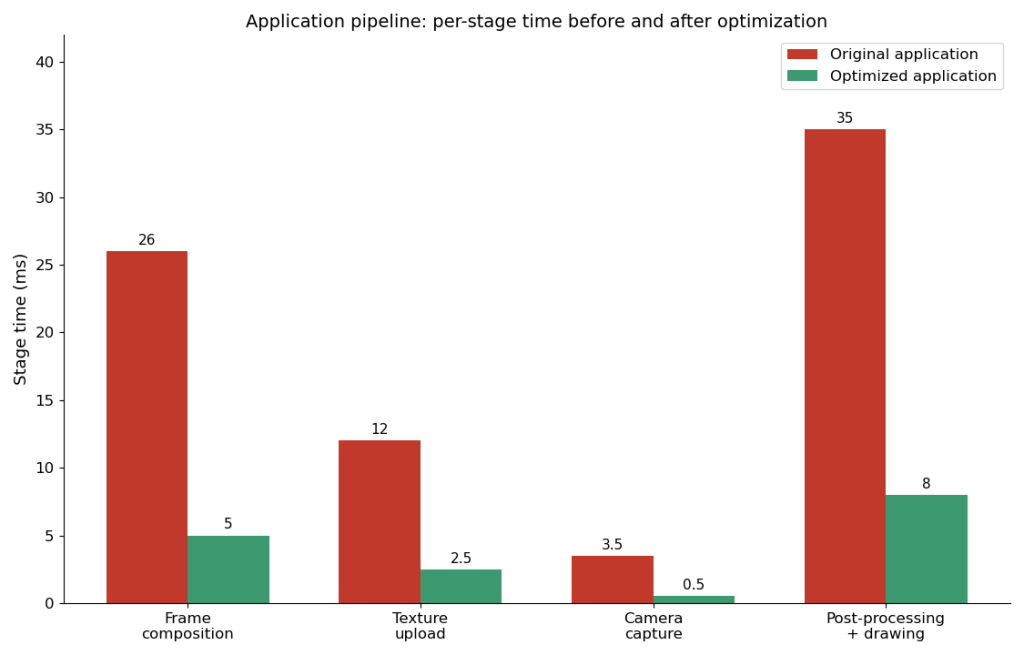
Le modèle était identique dans cette comparaison : les chiffres ci-dessous montrent uniquement l’effet des modifications apportées au programme. Les valeurs sont arrondies et proviennent d’un seul essai.
Étape ou mesure
Avant
Après
Composition de l’image
~22 à 30 ms
~5 ms
Transfert de l’image au GPU pour affichage
~10 à 14 ms
~2,5 ms
Post-traitement et dessin
~25 à 45 ms
~8 ms
Données transférées au GPU par image
~10 Mio
~1 Mio
Temps total par image
~90 à 130 ms
~31 à 35 ms
Cadence d’affichage
~8 à 11 i/s
~27 à 29 i/s
Comparaison avant-après issue d’un seul essai avec le même modèle. i/s signifie images par seconde. FPS est l’abréviation anglaise équivalente.
Durée approximative des étapes avant et après les changements.
Dans la plupart des essais, la cadence, qui était d’environ 11 images par seconde, a atteint 27 à 29 images par seconde, près de la limite de 30 images par seconde de la caméra. Nous n’avons pas modifié le modèle. Nous avons simplement supprimé des opérations répétées et confié la mise à l’échelle des images au processeur graphique.
Après ces changements, l’inférence occupait une plus grande part du temps de traitement de chaque image. Modifier le modèle pouvait donc enfin avoir un effet visible. Nous sommes alors revenus à l’élagage.
Revenir à l’élagage des modèles de segmentation d’instances
Un réseau neuronal contient des millions de valeurs apprises, appelées poids. L’élagage met à zéro les poids les moins utiles pendant ou après l’entraînement, dans le but de réduire le travail sans trop nuire à la précision.
Élagage des poids et élagage des canaux
Il existe deux grandes façons d’élaguer un modèle. L’élagage des poids met à zéro des poids individuels, mais conserve la taille de chaque couche. L’élagage des canaux retire des canaux entiers, ce qui change la taille des couches et la structure du modèle. Il peut supprimer davantage de calculs, mais modifie aussi plus profondément le réseau et demande généralement plus de réentraînement.
Nous avons utilisé la méthode d’élagage des poids du Renesas DRP-AI Extension Pack. Le modèle exporté conserve donc les mêmes dimensions de couches que le modèle non élagué, et son fichier ONNX garde à peu près la même taille. Le fichier compilé pour DRP-AI3 peut tout de même rétrécir, car le compilateur stocke les poids mis à zéro sous une forme compacte.
Comment DRP-AI3 exploite la sparsité des poids
DRP-AI3 utilise un schéma d’élagage N:M flexible. Les outils répartissent les poids en petits groupes de M candidats et conservent les N valeurs les plus utiles dans chaque groupe. N peut varier d’un groupe à l’autre. Le matériel dispose ainsi d’une organisation régulière, tout en permettant à chaque partie du modèle de conserver un nombre différent de poids.
Un modèle dont 70 % des poids ont été élagués ne sera toutefois pas simplement 70 % plus rapide. Les parties non élaguées s’exécutent toujours, les données circulent encore entre les étapes et les sorties doivent toujours être traitées. Le gain réel dépend du modèle et des opérations que DRP-AI3 peut éviter.
Avant le déploiement, chaque modèle est aussi converti au format INT8 (entiers sur 8 bits), une étape appelée quantification. Nous avons utilisé les mêmes images d’étalonnage et les mêmes réglages de quantification et de compilation pour les versions non élaguées et élaguées. Le taux d’élagage et la famille du modèle étaient donc les seules différences prévues dans ces essais.
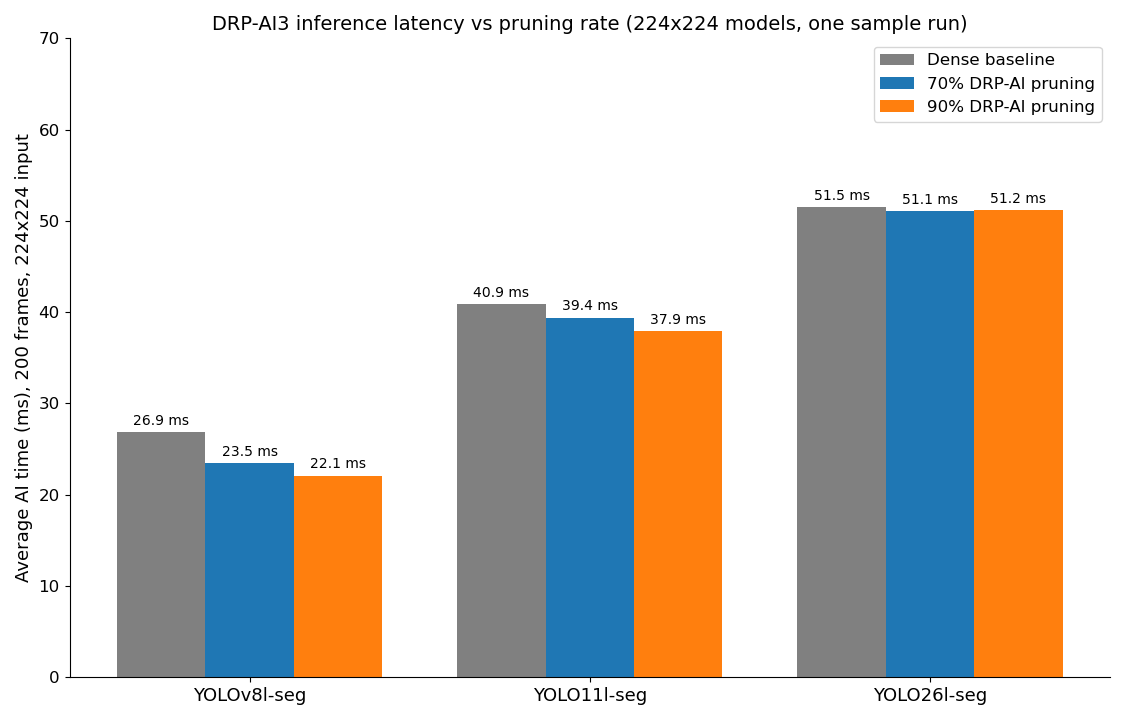
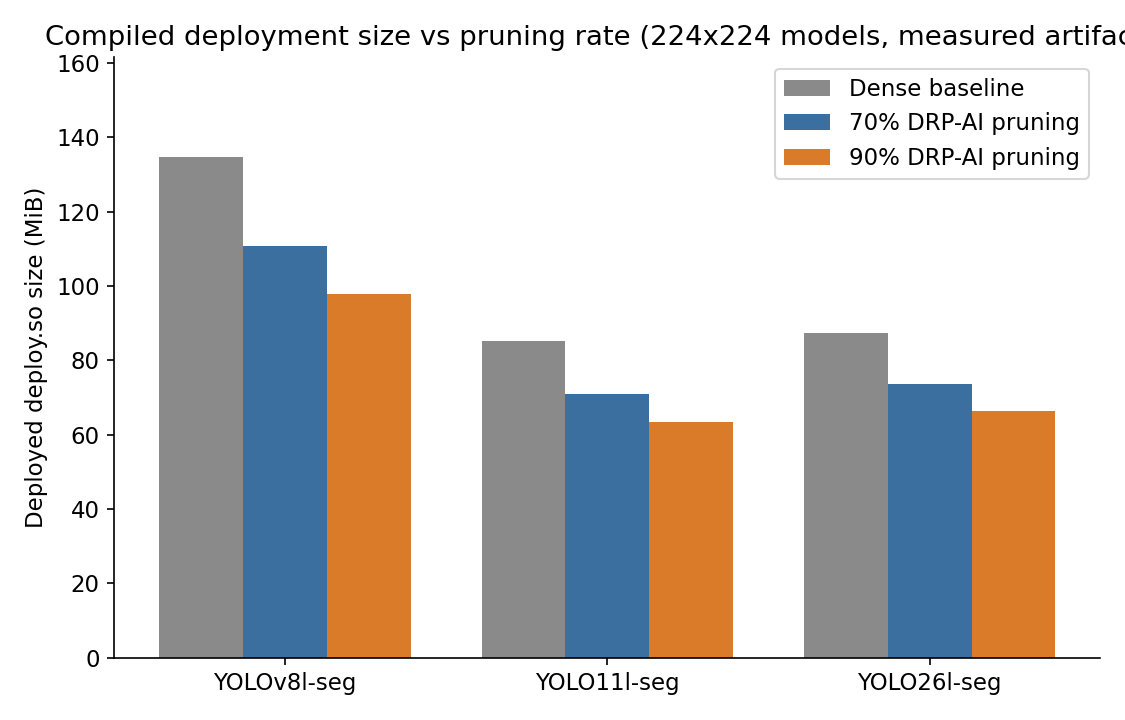
Pour les essais d’élagage de modèles de segmentation d’instances, nous avons utilisé trois grands modèles YOLO : YOLOv8l, YOLO11l et YOLO26l. Chacun a été testé dans une version de référence non élaguée et dans des versions élaguées à 70 % et à 90 %. Tous utilisaient une entrée de 224 × 224 et le même programme amélioré. Chaque résultat est la moyenne d’un seul essai de 200 images après une image de préchauffage. Il s’agit donc d’un essai contrôlé, et non d’une étude exhaustive.
Le programme réduisait chaque image de 320 × 240 de la caméra à l’entrée de 224 × 224 du modèle, en ajoutant des marges. L’affichage plein écran restait actif pendant les essais : ces mesures proviennent donc de l’application déployée avec la caméra, et non d’un outil qui mesure seulement le modèle.
Résultats de l’élagage sur la carte cible
Ici, nous avons mesuré uniquement l’exécution du modèle sur DRP-AI3. La capture, la préparation des entrées, les masques, le dessin et l’affichage sont exclus. Nous avons aussi relevé la taille du modèle compilé. Comme précédemment, les valeurs sont arrondies, car elles proviennent d’un seul essai.
Modèle
Temps d’inférence approximatif
Taille approximative du modèle compilé
YOLOv8l non élagué
~27 ms
~135 Mio
YOLOv8l, élagage à 70 %
~24 ms
~111 Mio
YOLOv8l, élagage à 90 %
~22 ms
~98 Mio
YOLO11l non élagué
~41 ms
~85 Mio
YOLO11l, élagage à 70 %
~39 ms
~71 Mio
YOLO11l, élagage à 90 %
~38 ms
~63 Mio
YOLO26l non élagué
~52 ms
~87 Mio
YOLO26l, élagage à 70 %
~51 ms
~74 Mio
YOLO26l, élagage à 90 %
~51 ms
~66 Mio
Un essai de 200 images sur le RZ/V2H. Les durées ne couvrent que l’exécution du modèle sur DRP-AI3.
Temps d’inférence selon le modèle et le taux d’élagage.Taille du modèle compilé selon le modèle et le taux d’élagage.
YOLOv8l a le plus profité de l’élagage
YOLOv8l a montré le gain le plus net. Le temps d’inférence est passé d’environ 27 ms à 24 ms avec un élagage à 70 %, puis à 22 ms à 90 %, soit environ 13 % et 18 % de moins. La taille du modèle compilé a aussi diminué d’environ 18 % et 27 %.
Ces gains sont utiles, mais restent bien inférieurs aux taux d’élagage. Le nombre de poids mis à zéro ne se traduit manifestement pas directement en vitesse.
YOLO11l s’est amélioré plus modestement
Le temps d’inférence de YOLO11l est passé d’environ 41 ms à 38 ms avec un élagage à 90 %, soit une réduction d’environ 7 %. La taille du modèle compilé a diminué d’environ un quart. L’élagage a donc aidé à la fois la vitesse et le stockage, mais le gain de vitesse est resté modeste.
YOLO26l est devenu plus petit, mais pas plus rapide
YOLO26l est resté près de 51 ms dans les trois versions, même si le modèle élagué à 90 % était environ 24 % plus petit. Un fichier de modèle plus petit ne garantit donc pas une inférence plus rapide.
La raison probable tient au graphe de calcul du modèle exporté. YOLOv8 et YOLO11 renvoient des détections brutes, puis laissent au processeur le soin d’éliminer les boîtes en double par suppression des non-maxima (NMS). YOLO26 réalise cette opération dans le modèle déployé.
Son graphe doit modifier la forme des données de sortie, les réordonner, les regrouper et les sélectionner. Ces opérations ne comportent pas de poids de convolution : l’élagage des poids ne peut donc pas les réduire, et leur coût reste inchangé même si le fichier compilé rétrécit. Les déplacements de données et l’ordonnancement ajoutent également un temps fixe.
Un même taux d’élagage peut donc avoir des effets très différents selon les modèles. La seule vérification fiable consiste à exécuter le modèle compilé sur la carte cible. Le nombre de poids et la taille des fichiers ne remplacent pas une mesure du temps d’exécution.
Un mot sur la précision des modèles
La vitesse ne représente qu’une partie de la décision. L’élagage retire de l’information apprise : il faut donc réentraîner le modèle et vérifier sa précision. Nos séances de réentraînement ont été courtes, car cet essai portait surtout sur les temps d’exécution.
Chaque modèle a été entraîné pendant dix époques sur environ 3 % de l’ensemble d’entraînement COCO, soit quelque 3 500 images, avec des lots de 64 et le même programme court pour chaque variante. La validation n’a été effectuée qu’une fois, à la fin. Cela permettait de comparer les variantes, mais ne suffisait pas, loin de là, pour que l’entraînement se stabilise.
Les modèles les plus élagués ont perdu en précision de segmentation. Il faut donc voir ces résultats comme des mesures de temps d’exécution, et non comme des modèles prêts à déployer. Un modèle destiné à la production nécessiterait un entraînement plus long, des essais sur des données représentatives de son utilisation réelle et, éventuellement, un taux d’élagage plus faible si la perte de précision demeure trop élevée.
L’essai répond tout de même à sa question principale : quel est l’effet de l’élagage sur le temps d’inférence de DRP-AI3 ? Le choix d’un modèle final exigerait aussi une étude approfondie de sa précision.
Ce que nous avons appris
Mesurer d’abord le traitement complet d’une image. L’inférence représentait environ un quart du temps initial par image. Commencer par le modèle aurait laissé de côté des coûts plus importants.
Éliminer les opérations répétées sur les images. Des images plus petites, le traitement groupé des masques et une seule fusion par image ont apporté les plus grands gains.
Confier à chaque composant le travail qui lui convient. Le processeur gère le programme, DRP-AI3 exécute le modèle et le processeur graphique met l’image à l’échelle pour l’affichage.
Le taux d’élagage ne prédit pas la vitesse. Avec 90 % d’élagage des modèles de segmentation d’instances, le gain allait d’environ 18 % pour YOLOv8l à presque zéro pour YOLO26l.
Plus petit ne veut pas toujours dire plus rapide. Les trois modèles occupaient moins d’espace après l’élagage, mais seuls deux s’exécutaient plus vite.
La précision reste importante. Un élagage important peut économiser du temps ou de l’espace, mais nécessiter davantage d’entraînement pour retrouver des résultats utiles.
Conclusion
La première version du programme affichait environ 8 à 11 images par seconde, et la majeure partie du délai se situait en dehors de DRP-AI3. C’est pourquoi nous avons commencé par le reste du programme plutôt que par le modèle.
La réduction de la taille de l’image affichée a apporté le plus grand gain. Le traitement groupé des masques, une seule fusion, la conversion d’une image plus petite, la réutilisation des tampons et la compression des images de la caméra ont ajouté d’autres améliorations. Avec le même modèle, le programme atteignait généralement 27 à 29 images par seconde, près de la limite de 30 de la caméra.
Nous avons ensuite testé l’élagage des modèles de segmentation d’instances. Avec un taux d’élagage de 90 %, YOLOv8l s’exécutait environ 18 % plus vite et YOLO11l environ 7 % plus vite, tandis que YOLO26l devenait plus petit sans accélérer. Chaque modèle réagissait différemment.
L’optimisation du programme n’est pas toujours plus importante que celle du modèle, ni l’inverse. Tout dépend de l’endroit où le temps de traitement des images est réellement consommé. Ici, les opérations hors inférence étaient le premier facteur limitant : nous les avons donc traitées en premier. L’élagage a ensuite permis de réduire une partie du temps restant.
L’optimisation de l’IA embarquée exige de considérer l’ensemble du système. Il faut mesurer le parcours de la caméra à l’écran, confier à chaque processeur les tâches auxquelles il est adapté et tester le modèle sur la carte cible sans négliger la précision. Si nous n’avions examiné que le réseau neuronal, nous serions passés à côté de l’essentiel des gains de ce projet.
Références
Renesas, Next Generation Highly Power-Efficient AI Accelerator DRP-AI3, février 2024
Segmentation d’Instances avec Invite Utilisateur: YOLOE-26 sur Hailo-10H Cet article présente la segmentation d’instances avec invite utilisateur via YOLOE-26 sur NPU Hailo-10H. Il détaille la modification du modèle, sa quantification INT8 et son optimisation jusqu’à 15,6 FPS (640px) et ~31 FPS (320px). La prise en charge du vocabulaire ouvert de YOLOE-26 permet aux opérateurs de […]
Estimation de profondeur monoculaire sur le Verdin i.MX95 Déploiement de l’estimation de profondeur monoculaire sur le Verdin i.MX95 pour l’IA embarquée : adaptation du modèle, quantification INT8 et une pile logicielle embarquée complète pour l’inférence de profondeur en temps réel à 30 FPS à partir d’une seule caméra RGB. L’estimation de profondeur monoculaire consiste […]
Démonstrations en direct au stand 4-642 (Hall 4) pour présenter des pipelines de vision par ordinateur avec l’IA en temps réel, optimisés pour les accélérateurs matériels embarqués et construits sur l’écosystème open source de l’IA. Nuremberg, Allemagne, le 6 mars 2026 – Savoir-faire Linux, une société leader dans le domaine de l’ingénierie logicielle open […]
Entraînement de YOLO pour la Détection Temps Réel sur Système LiDAR Il s’agit du deuxième volet d’une série en trois parties consacrée à la détection temps réel sur système LiDAR. Retrouvez ici l’article 1 sur la génération de jeux de données synthétiques de profondeur et NIR. Actuellement, de nouveaux LiDAR embarqués à basse résolution, tels […]
Permettre la Détection Temps Réel grâce à la Génération de Données LiDAR Synthétiques Cette série d’articles couvrira les éléments essentiels au déploiement d’un système de détection en temps réel avec un module dToF 3D LiDAR. Ce premier article est consacré à la génération de données LiDAR synthétiques. Génération de données LiDAR synthétiques pour la détection […]