Les agents IA de programmation savent désormais modifier un dépôt, lancer des tests et proposer des commits. Pourtant, écrire du code ne représente qu’une partie du travail d’ingénierie. Entre un ticket et un changement mergé, plusieurs étapes restent nécessaires : récupérer le contexte, préparer l’environnement, produire un patch, ouvrir une revue, attendre les commentaires et corriger le code jusqu’à son acceptation.
C’est précisément là que Virtual Engineer intervient. Cet orchestrateur open source et auto-hébergé fait entrer les agents IA dans l’ensemble de ce cycle. Pour cela, il connecte les systèmes qu’une équipe utilise déjà — tickets, dépôts Git et outils de revue de code — aux agents de programmation de son choix. Chaque cycle s’exécute dans une sandbox éphémère.
L’objectif n’est donc pas de remplacer le workflow de développement, mais plutôt de permettre aux agents IA d’y participer.
De l’assistant de programmation à l’ingénieur virtuel
Des outils comme Copilot, Claude Code, Aider ou d’autres agents IA peuvent déjà travailler sur un dépôt à la demande d’un développeur.
Virtual Engineer part d’une question différente : Que se passe-t-il si l’on ne donne pas simplement une instruction à l’agent, mais un ticket ?
Dans ce cas, l’agent doit pouvoir :
- Détecter qu’un ticket lui est assigné.
- Récupérer le dépôt et son contexte.
- Travailler dans un environnement isolé.
- Produire un changement.
- L’envoyer dans le système de revue existant.
- Comprendre les commentaires des reviewers.
- Produire une nouvelle itération.
- S’arrêter lorsque le changement est accepté ou lorsqu’un opérateur intervient.
C’est le rôle de l’orchestrateur.
Virtual Engineer prend en charge deux workflows complémentaires : la programmation à partir de tickets et la revue automatique de changements entrants.
1. Une architecture pour orchestrer le travail, pas pour remplacer les outils
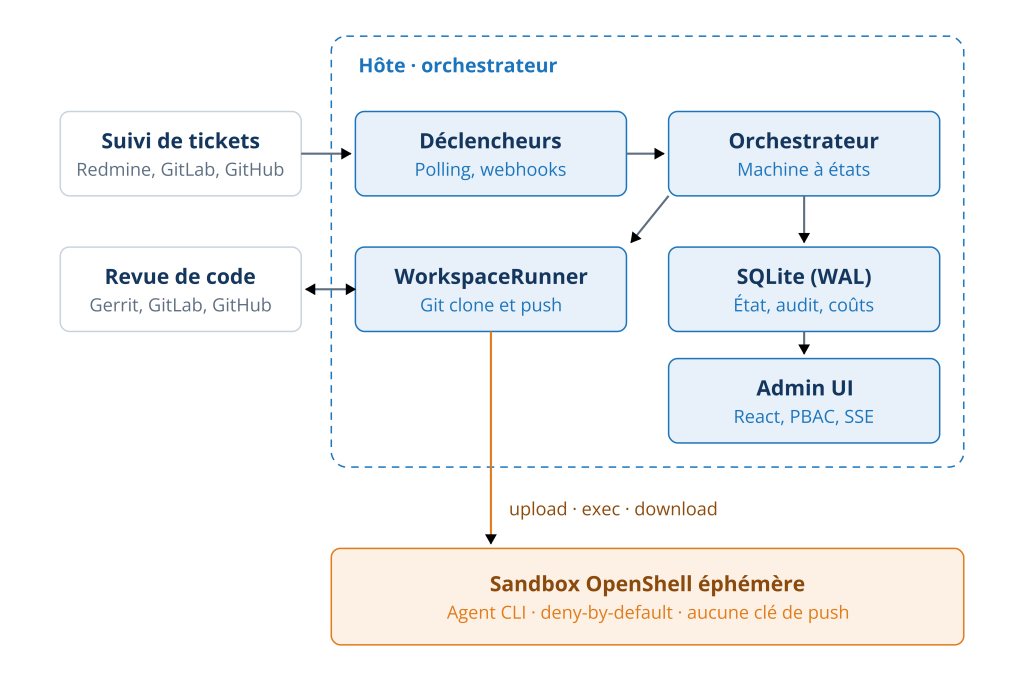
Figure 1 — Architecture de Virtual Engineer.
Au centre de Virtual Engineer se trouve un hôte orchestrateur développé en TypeScript.
Celui-ci reçoit les événements provenant des systèmes de suivi de tickets et de revue. Il pilote ensuite le workflow, conserve son état et délègue l’exécution du code à un WorkspaceRunner.
L’architecture repose sur quatre briques principales :
- Déclencheurs : polling et webhooks pour détecter le travail à effectuer ;
- Orchestrateur : machine à états qui pilote le cycle de vie d’une tâche ;
- SQLite (WAL) : persistance de l’état, de l’audit et des coûts ;
- Admin UI : interface React permettant de suivre et administrer les exécutions.
Par ailleurs, le WorkspaceRunner constitue la frontière opérationnelle entre cet hôte et la sandbox OpenShell éphémère.
Ce découpage est important : l’orchestrateur conserve la maîtrise du workflow et des opérations Git, tandis que l’agent dispose d’un environnement isolé dans lequel il peut réellement travailler.
Ainsi, le système n’introduit ni nouvelle plateforme de développement ni nouveau système de tickets. Il vient plutôt orchestrer les outils existants autour d’un agent.
Deux workflows, un même orchestrateur
Le premier workflow commence par un ticket.
Dans ce cas, Virtual Engineer surveille Redmine, GitLab Issues ou GitHub Issues. Lorsqu’un ticket est assigné, il prépare le contexte, lance un agent dans une sandbox et récupère le résultat pour le soumettre à Gerrit, GitLab ou GitHub.
Le second workflow fonctionne dans l’autre sens : lorsqu’un changement arrive en revue, Virtual Engineer peut demander à un agent d’analyser le diff, de publier des commentaires et de voter.
Ces deux usages ciblent donc deux moments différents du cycle de développement :
- produire un premier changement à partir d’un ticket ;
- produire un premier retour lorsqu’un changement arrive en revue.
Toutefois, la décision finale revient toujours à un humain. Virtual Engineer automatise le travail et le traitement du feedback, mais la revue humaine reste obligatoire.
2. Anatomie d’un cycle : de Git sur l’hôte au travail de l’agent
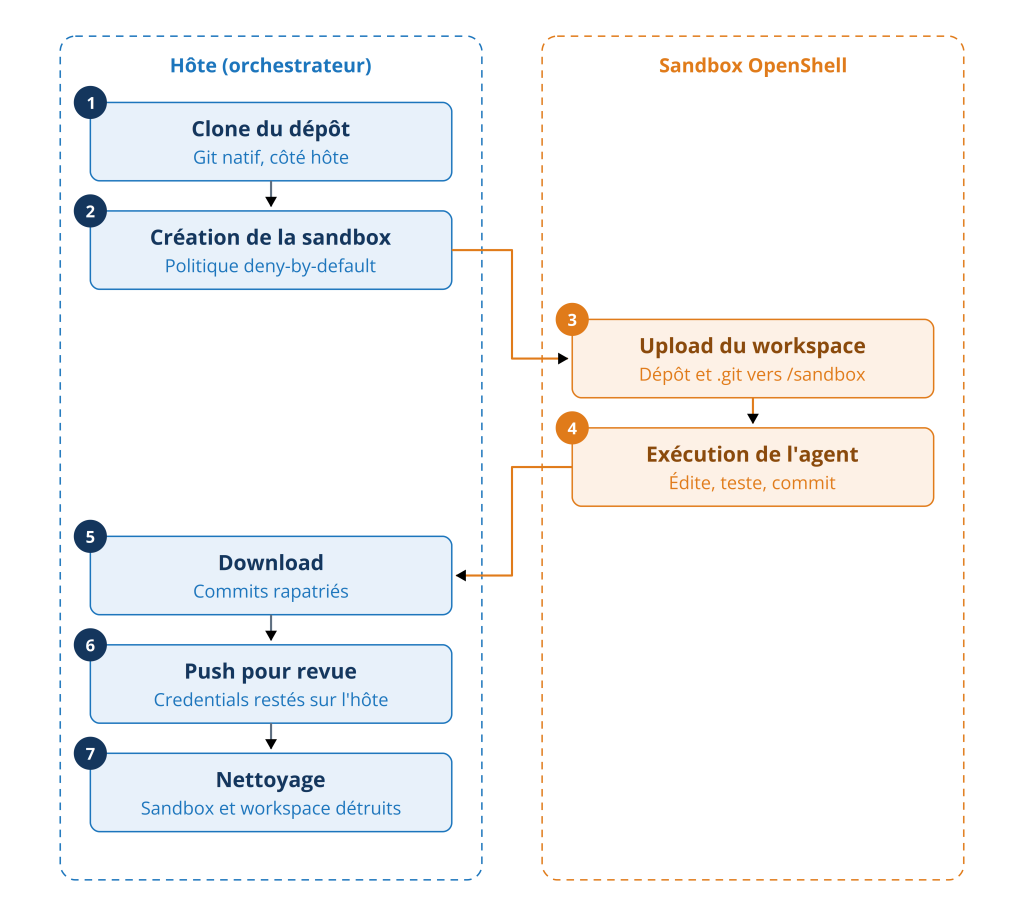
Figure 2 — Un cycle agent en sept étapes, entre l’hôte et la sandbox OpenShell.
Un cycle complet peut être résumé en sept étapes.
1. Clone du dépôt
D’abord, l’orchestrateur récupère le dépôt côté hôte, à l’aide des credentials nécessaires aux opérations Git.
2. Création de la sandbox
L’hôte crée ensuite une sandbox OpenShell éphémère avec une politique deny-by-default (tout refuser par défaut).
3. Upload du workspace
L’hôte copie alors le dépôt et son répertoire .git dans /sandbox.
4. Exécution de l’agent
Dans cet environnement isolé, l’agent lit le code, modifie les fichiers, lance les tests et crée ses commits.
5. Download
Une fois le travail terminé, l’hôte rapatrie le workspace et les commits produits.
6. Push pour revue
L’hôte pousse ensuite le changement vers le système de revue.
7. Nettoyage
Enfin, l’hôte détruit la sandbox et le workspace éphémère.
Le point architectural essentiel est que l’agent n’a pas besoin des credentials Git utilisés pour pousser le changement. Les opérations sensibles restent côté hôte.
La sandbox ne se limite donc pas à un conteneur dans lequel on lance une commande. Elle constitue une frontière d’exécution entre l’orchestrateur et l’agent.
3. Une machine à états pour transformer une exécution en workflow
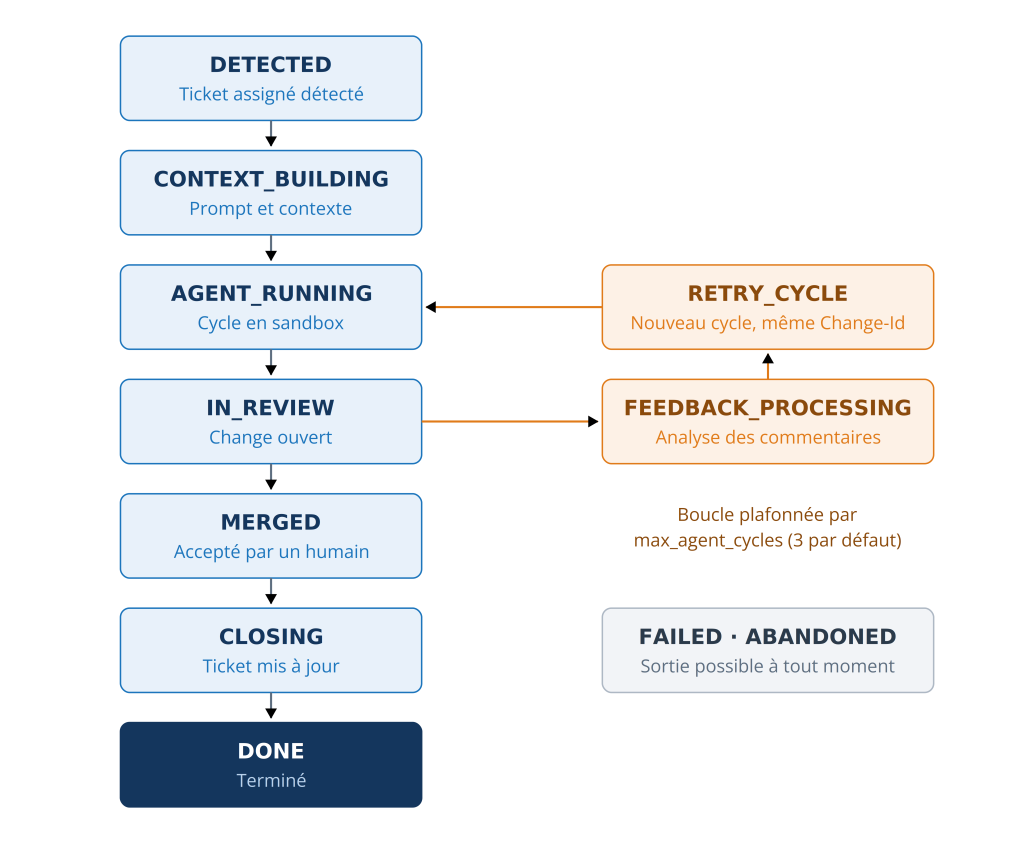
Figure 3 — La machine à états du workflow de code et sa boucle de feedback.
Une simple commande qui lance un agent puis attend son résultat ne suffit pas pour gérer un travail autonome.
Virtual Engineer représente plutôt chaque tâche par une machine à états explicite.
Le parcours nominal est :
DETECTED → CONTEXT_BUILDING → AGENT_RUNNING → IN_REVIEW → MERGED → CLOSING → DONE
Mais la revue peut également renvoyer le travail vers l’agent.
Lorsqu’un reviewer produit du feedback, le workflow passe par :
FEEDBACK_PROCESSING → RETRY_CYCLE → AGENT_RUNNING
L’agent repart alors avec le contexte du nouveau cycle.
Cette boucle est volontairement bornée par max_agent_cycles, avec 3 cycles par défaut, comme le montre le diagramme.
Sur Gerrit, les cycles successifs peuvent conserver le même Change-Id : les corrections apparaissent alors comme de nouveaux patchsets du même changement plutôt que comme une succession de contributions indépendantes.
De plus, un opérateur peut arrêter, reprendre ou abandonner une tâche.
La machine à états n’est donc pas seulement un détail d’implémentation. Elle rend explicite le contrat entre l’agent, l’orchestrateur et le processus de revue.
4. La frontière de confiance : l’agent ne reçoit que ce dont il a besoin
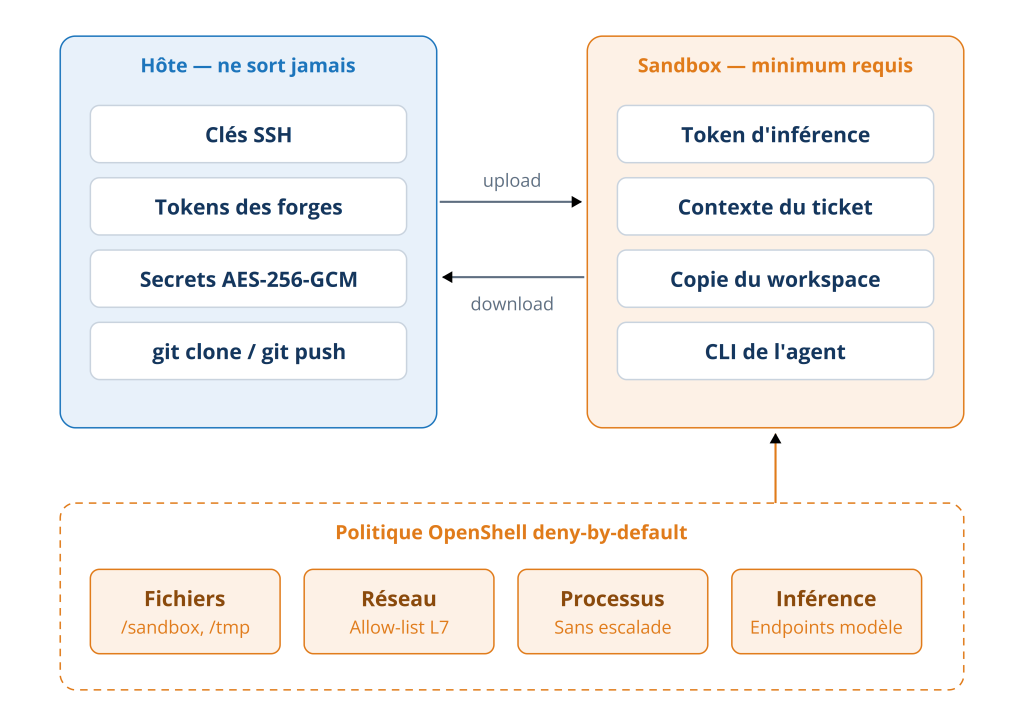
Figure 4 — La frontière de confiance entre l’hôte et la sandbox.
Le principe de sécurité de Virtual Engineer est simple : les credentials nécessaires au contrôle du dépôt restent sur l’hôte, tandis que l’agent travaille dans un environnement isolé.
Côté hôte, on trouve notamment :
- les clés SSH ;
- les tokens des forges ;
- les secrets chiffrés ;
- les opérations
git clone et git push.
À l’inverse, la sandbox ne reçoit que les éléments nécessaires à l’exécution de l’agent :
- le token d’inférence ;
- le contexte du ticket ;
- une copie du workspace ;
- la CLI de l’agent.
Une politique OpenShell deny-by-default complète cette séparation.
Le visuel la décompose en quatre domaines :
- Fichiers —
/sandbox et /tmp ; - Réseau — allow-list L7 ;
- Processus — pas d’escalade ;
- Inférence — endpoints modèle autorisés.
Il ne s’agit toutefois pas de prétendre qu’un agent ne peut jamais produire un résultat indésirable. L’approche consiste plutôt à réduire ses capacités et à maintenir les opérations sensibles hors de son environnement d’exécution.
Enfin, la sandbox est éphémère : une fois le cycle terminé, son environnement de travail est détruit.
5. Des capacités branchables plutôt qu’un agent imposé
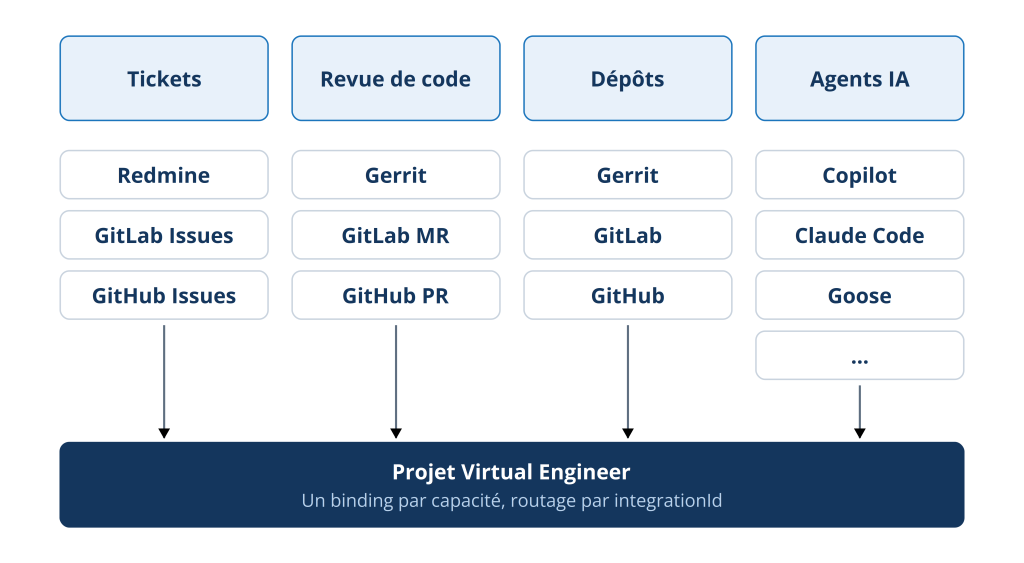
Figure 5 — Les capacités de Virtual Engineer sont séparées des fournisseurs qui les implémentent.
Virtual Engineer ne considère pas l’agent comme une dépendance unique.
Le système distingue quatre capacités :
issue_tracking ;code_review ;source_control ;agent_execution.
Vous pouvez ensuite relier chaque capacité à une intégration.
- Tickets : Redmine, GitLab Issues ou GitHub Issues, par exemple.
- Revue et dépôts : Gerrit, GitLab et GitHub.
- Agents IA : Copilot, Claude Code, Aider, Goose, Codex, Gemini CLI, OpenCode ou Cursor, selon les intégrations disponibles dans le projet.
L’intérêt de cette abstraction n’est pas seulement de proposer une longue liste de connecteurs. Elle permet surtout de conserver le même workflow lorsque le fournisseur change. Le projet relie ses capacités à des intégrations via integrationId. Plusieurs intégrations d’un même type peuvent aussi coexister.
L’orchestrateur devient ainsi une couche indépendante du moteur d’agent.
Une revue IA qui reste exploitable
Le deuxième workflow de Virtual Engineer consiste à analyser les changements produits par d’autres. Le problème est alors différent : une revue automatique qui produit trop de remarques peut rapidement faire plus de mal que de bien. Le système prévoit donc plusieurs mécanismes pour contrôler sa sortie :
- déduplication des commentaires ;
- filtrage des remarques qui ne correspondent pas aux lignes du diff ;
- seuil de sévérité ;
- limitation du volume de commentaires.
Bref, il s’agit de fournir un premier retour automatique et exploitable, avant la revue humaine.
Observer ce que font les agents IA
Les agents IA autonomes ajoutent une autre exigence : pouvoir comprendre ce qu’ils ont fait. Pour répondre à ce besoin, Virtual Engineer conserve l’état du workflow dans SQLite en mode WAL. Il enregistre aussi les transitions et les données de chaque cycle. L’interface d’administration permet ensuite de suivre les exécutions et les coûts.
Le diagramme d’architecture montre cette relation entre l’orchestrateur, SQLite et l’Admin UI : la persistance n’est pas un ajout, mais une partie centrale du workflow lui-même. Cette traçabilité compte surtout lorsque plusieurs tâches s’exécutent sans humain à chaque étape.
Un changement d’architecture plutôt qu’un nouvel outil de développement
Virtual Engineer ne cherche pas à remplacer les outils existants. Les agents IA viennent plutôt s’insérer dans votre système, avec un orchestrateur qui prend en charge leur cycle de vie. C’est ce qui distingue le projet d’un simple assistant de programmation. Un assistant attend généralement qu’un développeur le sollicite.
Virtual Engineer traite plutôt le cycle d’ingénierie comme unité d’exécution : ticket → contexte → agent → changement → revue → feedback → nouvelle itération → clôture
Et si les agents IA faisaient partie de l’équipe ?
C’est finalement la question à laquelle Virtual Engineer cherche à répondre. Les modèles savent produire du code. Les agents IA savent aussi utiliser des outils, modifier des dépôts et exécuter des tests. L’étape suivante consiste à les faire fonctionner dans les contraintes réelles d’une équipe :
- tickets ;
- dépôts ;
- règles de revue ;
- credentials ;
- politiques de sécurité ;
- outils de développement ;
- mécanismes de contrôle.
Virtual Engineer propose donc une infrastructure pour cette étape.
L’agent n’est plus seulement un outil que le développeur appelle. Il fait plutôt partie d’un workflow que l’équipe peut piloter, observer, interrompre et faire évoluer.
C’est là que se situe le rôle de Virtual Engineer : faire entrer les agents IA dans le processus d’ingénierie existant, plutôt que de demander à l’équipe de reconstruire son processus autour d’eux.
Essayer Virtual Engineer
Virtual Engineer est un projet open source auto-hébergé. Le dépôt et la documentation sont disponibles sur :
Une fois Virtual Engineer installé, vous pouvez configurer les intégrations, les agents et les projets depuis l’interface d’administration.
Le premier test peut rester très simple : connecter un système de tickets, un dépôt, un agent, puis assigner un ticket.
Pour aller plus loin, découvrez nos autres articles sur l’intelligence artificielle.